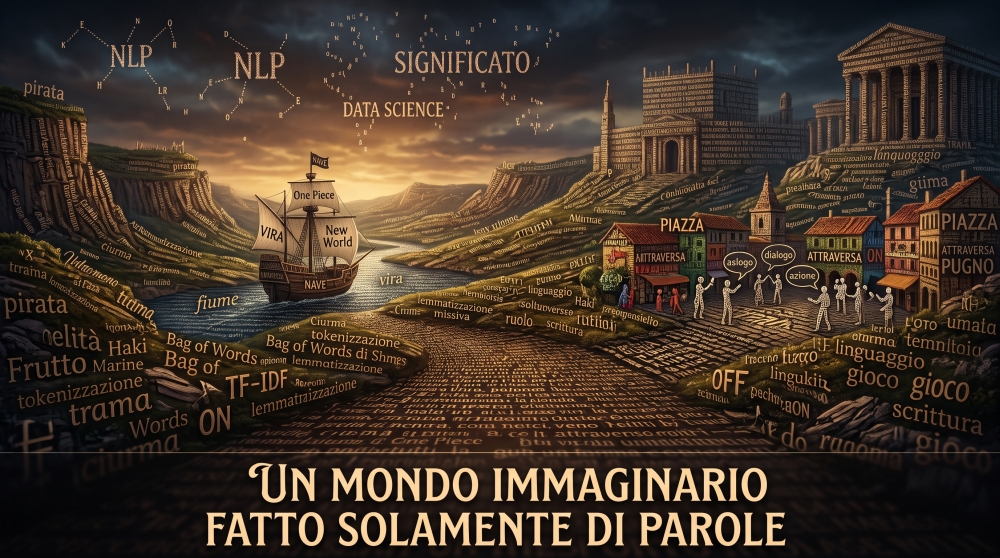
Un mondo immaginario fatto solamente di parole
In un GDR Play by Chat un pugno non parte davvero, una nave non vira e nessuno attraversa una piazza. Eppure tutte queste cose accadono. Accadono perché un giocatore le scrive, un altro le legge e il mondo condiviso accetta quelle parole come un evento. È questa la differenza fondamentale rispetto a gran parte dei videogiochi quando si prova a parlare di Natural Language Processing: lì il testo accompagna spesso il gioco; qui, molto più radicalmente, contribuisce a costruirlo.
Prendiamo New World GDR, land Play by Chat ambientata nell’universo di One Piece. La scheda pubblica di GDR-online la descrive come un PbC con turnazione fissa basata sull’ordine d’ingresso e presenza di PvP; gli aggiornamenti più recenti citano inoltre un log delle proprie azioni e le Missive di Trama, attraverso cui più giocate collegate possono concorrere alla costruzione di un percorso narrativo, con particolare attenzione a ciò che nasce e si sviluppa nel gioco ON [14]. Non serve trasformare New World in una recensione per cogliere il punto: una parte consistente della sua realtà ludica è conservata sotto forma di testo.
Da qui nasce una domanda meno fantascientifica di quanto sembri: che cosa succederebbe chiedendo a una macchina di leggere migliaia di quelle azioni? Potrebbe distinguere un combattimento da una conversazione? Riconoscere una minaccia, una fuga, l’uso ricorrente di un certo lessico, il modo in cui si sviluppa una trama? Prima di domandarci quanto sia brava a farlo, bisogna affrontare una questione più semplice e più importante: che cosa vede davvero?
Prima del significato vengono i dati
Un giocatore legge una role e compie una quantità impressionante di inferenze senza rendersene conto. Capisce chi si muove, verso dove, con quale intenzione; distingue un dialogo da una descrizione, coglie ironia, aggressività, esitazione, riferimenti alla lore e contenuto tecnico. Se conosce l’ambientazione riconosce Haki, Frutti, Marine, ciurme, tecniche e gerarchie quasi senza interrompere la lettura.
Un algoritmo tradizionale non riceve automaticamente nulla di tutto questo. Riceve testo. Il Natural Language Processing, o NLP, è il campo che studia come permettere a un computer di lavorare con il linguaggio umano; il Machine Learning entra in gioco quando vogliamo che un modello impari determinate regolarità dai dati invece di codificare manualmente ogni possibile regola.
Il problema è stato affrontato anche nell’ambito della tesi triennale in Statistica del sottoscritto (Al momento sotto Embargo Accademico per molti contenuti dietro NDA), utilizzando proprio New World GDR come caso di studio. L’aspetto interessante dell’esperimento non è immaginare una macchina che “comprenda” una role come un giocatore, ma osservare quanto il comportamento del modello dipenda da ciò che decidiamo di mostrargli.
Perché prima di classificare una role bisogna rappresentarla. Ed è in quel passaggio, apparentemente tecnico, che cominciano già le interpretazioni.
Svuotare una role sopra il tavolo
Prendiamo un esempio costruito:
«Il pirata arretrerebbe il piede destro, serrando la presa sull’elsa prima di tentare un affondo verso il fianco dell’avversario.»
Per noi contiene almeno un movimento, un’arma, un’intenzione offensiva e un bersaglio. Per una pipeline NLP classica, all’inizio, è una stringa da segmentare. La tokenizzazione la spezza in unità - semplificando, parole e segni - sulle quali possono poi essere costruite delle caratteristiche numeriche.
Una delle rappresentazioni più note è la Bag of Words. L’immagine più semplice è questa: prendiamo la role, svuotiamo tutte le parole sopra un tavolo e dimentichiamo in buona parte la posizione in cui si trovavano. Restano “pirata”, “piede”, “elsa”, “affondo”, “fianco”, “avversario”, insieme alle loro frequenze.
Il documento diventa così un vettore di numeri: per ogni termine del vocabolario possiamo registrare se compare e quante volte. È la stessa famiglia concettuale di rappresentazioni che ha dato origine al Vector Space Model, nel quale documenti e termini possono essere trattati matematicamente come vettori in uno spazio di caratteristiche [1].
Sembra una perdita brutale di informazione, e in parte lo è. “Il pirata colpisce il Marine” e “il Marine colpisce il pirata” possono diventare molto più simili di quanto dovrebbero. Ma sarebbe un errore liquidare Bag of Words come un giocattolo primitivo: la storia dell’information retrieval e della text classification mostra quanto rappresentazioni basate sui termini, se pesate correttamente, possano essere robuste ed efficaci [2, 3].
Il punto non è che vedano tutto. Bensì sapere con precisione che cosa decidiamo di far loro vedere.
Lemmatizzare significa cambiare il testo matematico
Qui entra in scena la lemmatizzazione. In italiano la stessa idea può apparire sotto forme diverse: “colpisce”, “colpire”, “colpiva”, “colpito”; oppure “combatte”, “combattere”, “combatteva”. Senza normalizzazione queste forme possono occupare colonne differenti nella rappresentazione numerica. La lemmatizzazione tenta invece di ricondurle a una forma di base comune.
Non stiamo soltanto “pulendo” il testo. Stiamo modificando il modo in cui quel testo esiste matematicamente.
Immaginiamo allora due pipeline applicate alle stesse role di New World. Nella prima il testo originale passa direttamente a Bag of Words e poi a un classificatore. Nella seconda viene prima lemmatizzato, quindi trasformato con la stessa Bag of Words e consegnato allo stesso identico algoritmo.
Il modello finale può essere uguale, i documenti iniziali pure, e tuttavia i risultati possono cambiare.
Non abbiamo cambiato il cervello della macchina, quanto "cambiato" gli occhiali attraverso i quali guarda la role.
Nella prima rappresentazione “colpire”, “colpisce”, “colpiva” e “colpito” possono costituire quattro segnali diversi; nella seconda diventano un segnale più compatto. Cambiano il vocabolario, le frequenze, la quantità di caratteristiche e i pesi che il modello può apprendere.
Dire che il modello “ragiona diversamente” è quindi una scorciatoia linguistica: non gli stiamo attribuendo coscienza, stiamo dicendo che riceve variabili differenti e può produrre classificazioni differenti.
Ed è qui che la letteratura diventa interessante, perché il preprocessing non migliora automaticamente un sistema. Uysal e Gunal hanno mostrato quanto la scelta delle operazioni di preparazione del testo possa influire sulle prestazioni di una classificazione [4]; Toman, Tesar e Jezek, confrontando diverse tecniche di normalizzazione su corpora inglesi e cechi, non hanno rilevato un vantaggio generale di stemming e lemmatizzazione e hanno osservato diversi casi nei quali la normalizzazione peggiorava le prestazioni [5].
Più recentemente Siino, Tinnirello e La Cascia hanno mostrato come la sensibilità al preprocessing rimanga anche con modelli moderni e come la scelta più efficace dipenda dal dataset, dal compito e dall’algoritmo utilizzato [6].
Questo è un passaggio meno banale di quanto sembri. Il preprocessing viene spesso raccontato come una successione quasi inevitabile di miglioramenti: si pulisce il testo, si elimina ciò che disturba, si consegna al modello una versione più ordinata della realtà.
Ma “ordinata” e “migliore” non sono sinonimi.
Un termine apparentemente ridondante può essere un segnale utile; una variazione grammaticale può distinguere due tipi di scrittura; persino qualcosa che sembra rumore potrebbe contenere una regolarità sfruttabile dal classificatore.
Non tutte le parole pesano allo stesso modo
Bag of Words può essere affiancata da TF-IDF, una tecnica costruita attorno a un’idea piuttosto intuitiva: una parola non è necessariamente informativa soltanto perché compare molte volte.
Se un termine appare praticamente ovunque, aiuta poco a distinguere un documento dagli altri; un termine più raro e caratteristico può invece risultare molto più significativo. Il principio della specificità statistica dei termini è uno dei fondamenti storici dell’information retrieval [7], e i sistemi di pesatura dei termini hanno dimostrato da tempo quanto il modo in cui assegniamo importanza alle parole possa incidere sul recupero e sulla rappresentazione dei documenti [2].
In un ipotetico corpus di New World parole come “Haki”, “Frutto”, “Marine”, “ciurma” o “spadaccino” potrebbero quindi assumere pesi differenti a seconda della loro distribuzione. Sono esempi illustrativi, non risultati misurati sul dataset ndr.
TF-IDF prova, semplificando, a bilanciare quanto un termine conta dentro una singola role con quanto sia comune nell’intera raccolta.
Anche qui la rappresentazione precede l’apprendimento. Prima ancora che il classificatore cerchi un confine tra due categorie, qualcuno ha deciso quali parole esistono come caratteristiche, quali sono state accorpate e quanto debbano pesare.
L’algoritmo impara dentro quello spazio; non al di fuori.
Il problema magnifico dello stile
Un GDR testuale rende tutto questo più difficile e, proprio per questo, più interessante. Due giocatori possono compiere la stessa azione meccanica usando superfici linguistiche quasi opposte.
Uno scrive:
«Tenta di colpirlo con un pugno.»
Un altro costruisce la medesima intenzione attraverso postura, distanza, ambiente, ritmo, percezioni, metafore e una descrizione lunga centinaia di caratteri.
Per il regolamento potrebbero stare tentando qualcosa di molto simile. Per un modello basato prevalentemente sulle parole, potrebbero sembrare documenti lontanissimi.
La stilometria studia da decenni quanto elementi come frequenze lessicali, lunghezza delle frasi, caratteri, strutture sintattiche e altre abitudini possano costituire una sorta di impronta statistica dell’autore. La rassegna di Stamatatos mostra l’ampiezza delle caratteristiche utilizzabili per quantificare lo stile [8]; Zheng e colleghi, lavorando sui messaggi online, hanno mostrato inoltre come caratteristiche lessicali, sintattiche, strutturali e legate al contenuto possano contribuire tutte alla distinzione fra autori [9].
In una land questo significa che ciò che potremmo essere tentati di chiamare “rumore” può contenere informazione: sinonimi, preferenze verbali, onomatopee, dialoghi, punteggiatura, tecnicismi, nomi propri, abilità, formule ricorrenti, lunghezza dell’azione.
New World diventa così un piccolo laboratorio linguistico. I giocatori condividono un universo, regole, convenzioni e una parte del vocabolario, ma non condividono la stessa voce. Una tecnica può essere raccontata in dieci modi; un movimento può occupare una riga o un intero paragrafo.
La domanda smette allora di essere “come puliamo meglio il testo?” e diventa: quanto di questa diversità vogliamo conservare?
Bag of Words sacrifica l’ordine. La lemmatizzazione riduce differenze morfologiche. TF-IDF cambia il peso relativo delle parole. Nessuna lente è neutrale e nessuna è automaticamente superiore.
Pulire un testo significa anche scegliere cosa siamo disposti a dimenticare.
Dai log alle trame, e tutto ciò che c'è in mezzo
La letteratura scientifica specificamente dedicata ai Play by Chat italiani è, almeno allo stato della ricerca bibliografica svolta per questo articolo, molto scarsa. Esistono però territori vicini.
I MUD costituiscono forse il precedente più evidente: ambienti di ruolo online testuali nei quali il giocatore interagisce con un mondo condiviso e con gli altri partecipanti attraverso il linguaggio. Non si tratta soltanto di un’analogia teorica: uno studio etnografico di Simona Isabella ha analizzato proprio due MUD, uno italiano e uno canadese, affrontando il rapporto fra gioco, comunicazione, identità e costruzione dell’esperienza online [10].
La computational narrative osserva invece come storie, eventi, spazi e strutture narrative possano essere rappresentati o sostenuti attraverso sistemi computazionali [11], mentre la ricerca sull’Interactive Fiction utilizza mondi completamente testuali come banco di prova per agenti che devono interpretare linguaggio, azioni e stato dell’ambiente [12].
Il collegamento con un Play by Chat non è perfetto, ma è istruttivo: in tutti questi casi il linguaggio non è soltanto contenuto da analizzare, bensì parte della struttura attraverso cui l’esperienza viene prodotta.
Applicato con prudenza a un PbC, l’NLP potrebbe servire per cercare dentro grandi archivi di log, raggruppare giocate per contesto, individuare pattern lessicali, supportare la classificazione delle azioni, ricostruire fili narrativi o facilitare la consultazione di regolamento, lore e documentazione.
Nel caso di una land che conserva le azioni e valorizza percorsi composti da più giocate, come accade nelle attuali Missive di Trama di New World, la prospettiva di strumenti capaci di collegare eventi dispersi lungo diverse role diventa particolarmente intuitiva [14].
L’aggiornamento delle Missive pubblicato nel settembre 2026 è interessante proprio in questa prospettiva: una singola missiva può raccogliere più giocate collegate allo stesso spunto, mentre collaborazioni, alleanze e rapporti fra personaggi devono nascere principalmente attraverso il gioco ON [14].
Per un essere umano seguire quel filo significa ricordare personaggi, intenzioni, eventi e conseguenze disseminati lungo diverse sessioni. Per una macchina significherebbe prima di tutto capire quali frammenti di testo appartengono allo stesso percorso narrativo.
Sembra una differenza sottile, ma contiene buona parte del problema.
I Transformer e i Large Language Model spostano molto più avanti questa capacità, perché riescono a conservare e utilizzare relazioni contestuali che una Bag of Words perde quasi completamente. Ma non cancellano il problema di fondo.
Anche un modello moderno dipende dai dati, dal contesto che gli viene fornito, dal modo in cui recuperiamo i documenti e da ciò che consideriamo rilevante. La ricerca recente sul preprocessing mostra, anzi, che persino i Transformer possono reagire in maniera sensibile alle trasformazioni applicate al testo [6].
E soprattutto esiste un confine che, nel Play by Chat, vale la pena difendere. Usare l’AI per ritrovare una vecchia giocata, riassumere una lunga quest o aiutare un master a orientarsi fra anni di documentazione è una cosa; delegarle integralmente la produzione delle role è un’altra.
La ricerca sugli strumenti computazionali destinati alla scrittura creativa tende infatti a ragionare non soltanto in termini di generazione automatica, ma anche di supporto alla creatività, co-creazione e tutela dell’intenzione espressiva dell’autore [13].
Nel gioco testuale questa distinzione pesa ancora di più: la scrittura non è il fastidioso tramite tra il giocatore e il gioco. È gioco.
In un MMORPG tradizionale il linguaggio può accompagnare l’esperienza: chat, dialoghi, recensioni, ticket, descrizioni. In un Play by Chat la distinzione si assottiglia fino quasi a sparire.
Ogni azione inviata è contemporaneamente una decisione ludica, un frammento narrativo, una traccia del personaggio e un oggetto linguistico.
È per questo che applicare NLP e Machine Learning a una land come New World non significa semplicemente “analizzare una chat”. Significa prendere la materia con cui il mondo viene costruito e decidere come trasformarla in numeri.
Ogni scelta - tokenizzare, lemmatizzare, contare, pesare, conservare o eliminare - mette qualcosa a fuoco e lascia qualcos’altro ai margini.
Quanto ciò che un giocatore comprende naturalmente leggendo una role riesce davvero a sopravvivere quando quella stessa role viene trasformata in dati, è un'ottima domanda da porsi per esplorare questo complicata branca della statistica.
Fonti e approfondimenti
[1] Salton, G., Wong, A., Yang, C. S. (1975), A Vector Space Model for Automatic Indexing, Communications of the ACM, 18(11), 613–620. DOI: 10.1145/361219.361220.
[2] Salton, G., Buckley, C. (1988), Term-Weighting Approaches in Automatic Text Retrieval, Information Processing & Management, 24(5), 513–523. DOI: 10.1016/0306-4573(88)90021-0.
[3] Song, F., Liu, S., Yang, J. (2005), A Comparative Study on Text Representation Schemes in Text Categorization, Pattern Analysis and Applications, 8, 199–209. DOI: 10.1007/s10044-005-0256-3.
[4] Uysal, A. K., Gunal, S. (2014), The Impact of Preprocessing on Text Classification, Information Processing & Management, 50(1), 104–112. DOI: 10.1016/j.ipm.2013.08.006.
[5] Toman, M., Tesar, R., Jezek, K. (2006), Influence of Word Normalization on Text Classification, Proceedings of InSciT, 354–358.
[6] Siino, M., Tinnirello, I., La Cascia, M. (2024), Is Text Preprocessing Still Worth the Time? A Comparative Survey on the Influence of Popular Preprocessing Methods on Transformers and Traditional Classifiers, Information Systems, 121, 102342. DOI: 10.1016/j.is.2023.102342.
[7] Spärck Jones, K. (1972), A Statistical Interpretation of Term Specificity and Its Application in Retrieval, Journal of Documentation, 28(1), 11–21. DOI: 10.1108/eb026526.
[8] Stamatatos, E. (2009), A Survey of Modern Authorship Attribution Methods, Journal of the American Society for Information Science and Technology, 60(3), 538–556. DOI: 10.1002/asi.21001.
[9] Zheng, R., Li, J., Chen, H., Huang, Z. (2006), A Framework for Authorship Identification of Online Messages: Writing-style Features and Classification Techniques, Journal of the American Society for Information Science and Technology, 57(3), 378–393. DOI: 10.1002/asi.20316.
[10] Isabella, S. (2007), Ethnography of Online Role-Playing Games: The Role of Virtual and Real Contest in the Construction of the Field, Forum Qualitative Sozialforschung / Forum: Qualitative Social Research, 8(3), Art. 36. DOI: 10.17169/fqs-8.3.280.
[11] Kybartas, Q., Bidarra, R. (2017), A Survey on Story Generation Techniques for Authoring Computational Narratives, IEEE Transactions on Computational Intelligence and AI in Games, 9(3), 239–253. DOI: 10.1109/TCIAIG.2016.2546063.
[12] Hausknecht, M., Ammanabrolu, P., Côté, M.-A., Yuan, X. (2020), Interactive Fiction Games: A Colossal Adventure, Proceedings of the AAAI Conference on Artificial Intelligence, 34(05), 7903–7910. DOI: 10.1609/aaai.v34i05.6297.
[13] Kreminski, M., Martens, C. (2022), Unmet Creativity Support Needs in Computationally Supported Creative Writing, Proceedings of the First Workshop on Intelligent and Interactive Writing Assistants, 74–82. Association for Computational Linguistics. DOI: 10.18653/v1/2022.in2writing-1.11.
[14] New World GDR, sito ufficiale:
https://newworldgdr.com
[15] GDR-online.com, scheda New World GDR – Play by Chat One Piece e sezione News e Annunci New World GDR, consultate nel settembre 2026:
https://www.gdr-online.com/new_world_gdr.asp